Caudas Longas
Caudas longas se referem a pequenos números de amostras que ocorrem um grande número de vezes. Quando representamos esses dados graficamente, eles formam uma pequena faixa bem à direita do centro de massa que se parece com uma cauda. Elas indicam a presença de valores discrepantes cujo comportamento incomum pode ser de nosso interesse.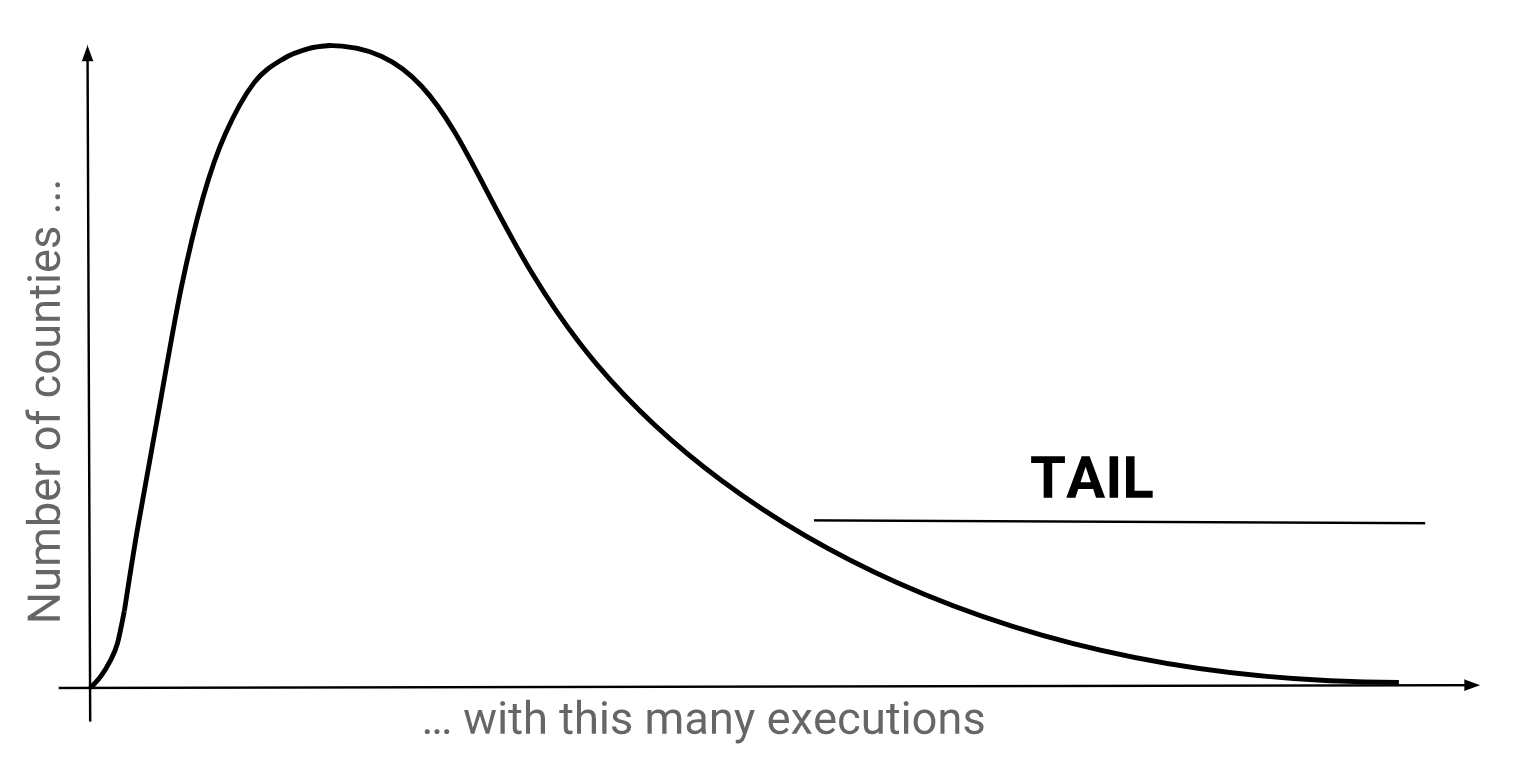 No contexto das execuções no Texas, a cauda longa se refere a um pequeno número de condados que são conhecidos por realizar um grande número de execuções.
Vamos encontrar a porcentagem de execuções de cada condado para que possamos identificar aquelas que estão na cauda.
Como ficará cada vez mais evidente, o formato das tabelas nos diz muito sobre as operações que precisamos realizar. (Isso é análogo à análise dimensional na física.) Neste caso, podemos perceber que os métodos que cobrimos até agora são inadequados: o capítulo Beazley lidou com linhas individuais de dados, mas está claro que precisamos fazer alguma agregação para encontrar dados por condado. O capítulo Alegações de Inocência nos ensinou agregação, mas essas funções acabariam agregando o conjunto de dados em uma única linha quando, na verdade, queremos uma linha por condado.
O Bloco GROUP BY
É aqui que entra o bloco GROUP BY. Ele nos permite dividir o conjunto de dados e aplicar funções de agregação dentro de cada grupo, resultando em uma linha por grupo. Sua forma mais básica é GROUP BY <column>, <column>, ... e vem depois do bloco WHERE.
Se você se lembra de Uma Consulta Estranha, sinais de alerta estariam aparecendo na sua cabeça. Nós não acabamos de aprender a não misturar colunas agregadas e não agregadas? A diferença aqui é que as colunas de agrupamento são as únicas colunas permitidas para não serem agregadas. Afinal, todas as linhas nesse grupo devem ter os mesmos valores nessas colunas, então não há ambiguidade no valor que deve ser retornado.
Você também pode ter notado nosso uso de AS. É o que chamamos de “aliasing” (criação de apelidos). No bloco SELECT, <expression> AS <alias> fornece um apelido que pode ser consultado posteriormente na consulta. Isso nos poupa de reescrever expressões longas e permite esclarecer o propósito da expressão.
O Bloco HAVING
Este próximo exercício ilustra que a filtragem pelo bloco WHERE acontece antes do agrupamento e da agregação. Isso é refletido na ordem da sintaxe, já que o bloco WHERE sempre precede o bloco GROUP BY.
Tudo isso está correto, mas o que acontece se quisermos filtrar o resultado do agrupamento e da agregação? Certamente não podemos avançar no futuro e pegar informações de lá. Para resolver esse problema, usamos HAVING.
Prática
Este questionário foi criado para desafiar sua compreensão. Leia as explicações mesmo se você acertar tudo.
Consultas Aninhadas
Agora, você pode perguntar: não teríamos terminado se pudéssemos simplesmente executar algo assim?
SELECT
  county,
  PERCENT_COUNT(*)
FROM executions
GROUP BY county
Porcentagens são uma métrica tão comum — uma função assim não deveria existir? Infelizmente não, e talvez por uma boa razão: uma função assim precisaria agregar tanto dentro dos grupos (para obter o numerador) quanto em todo o conjunto de dados (para obter o denominador). Mas cada consulta ou tem um bloco GROUP BY ou não tem. Então o que realmente precisamos são duas consultas separadas, uma que agrega com um GROUP BY e outra que agrega sem ele. Podemos então combiná-las usando uma técnica chamada “aninhamento”.
Aqui está um exemplo de como o aninhamento funciona. Os parênteses são importantes para demarcar o limite entre a consulta interna e a externa:
Repetindo, o aninhamento é necessário aqui porque, na cláusula WHERE, enquanto o computador inspeciona uma linha para decidir se sua declaração final tem o tamanho correto, ele não pode olhar para fora para descobrir o tamanho máximo em todo o conjunto de dados. Precisamos encontrar o tamanho máximo separadamente e alimentá-lo na cláusula. Agora vamos aplicar o mesmo conceito para encontrar a porcentagem de execuções de cada condado.
Eu inseri silenciosamente um bloco ORDER BY. Seu formato é ORDER BY <column>, <column>, ... e ele pode ser modificado adicionando DESC se você não quiser a ordem crescente padrão.
Condado de Harris
É surpreendente que Harris (lar da cidade de Houston), Dallas, Bexar e Tarrant representem cerca de 50% de todas as execuções no Texas? Talvez seja, especialmente se começarmos com a suposição de que as execuções deveriam ser distribuídas igualmente entre os condados. Mas uma primeira aproximação melhor é que as execuções são distribuídas de acordo com a distribuição populacional. O Censo do Texas de 2010 mostra que os 4 condados tinham uma população de 10,0 milhões, o que representa 40,0% da população do Texas (25,1 milhões). Isso torna a descoberta um pouco menos surpreendente.
Mas ao dividir essa cauda ainda mais, percebemos que o condado de Harris representa a maior parte da diferença. Ele tem apenas 16,4% da população, mas 23,1% das execuções. Isso é quase 50% a mais do que deveria ter.
Vários estudos examinaram por que o condado de Harris foi tão prolífico e vários fatores foram sugeridos:
-
Os processos judiciais foram organizados e bem financiados, enquanto as defesas foram financiadas pelo tribunal e tiveram poucos incentivos. (Fonte, veja p49)
-
O promotor distrital de longa data era determinado e entusiasmado com a pena de morte.
-
Juízes no Texas são eleitos, e a população apoiava a pena de morte. (Fonte)
-
Os mecanismos de controle e equilíbrio no sistema judicial do condado de Harris não funcionaram. (Fonte, veja p929)
Recapitulação
Nesta seção, aprendemos a agregar sobre grupos e a usar aninhamento para utilizar a saída de uma consulta interna em uma consulta externa. Essas técnicas têm o benefício muito prático de permitir o cálculo de porcentagens.
MapReduce
Um adendo interessante é que acabamos de aprender a fazer MapReduce em SQL. MapReduce é um famoso paradigma de programação que vê os cálculos como ocorrendo em uma etapa de "map" e uma etapa de "reduce". Você pode aprender mais sobre MapReduce aqui.
O capítulo Beazley era todo sobre mapeamento porque mostrou como mapear várias operações para todas as linhas. Por exemplo, SELECT LENGTH(last_statement) FROM executions mapeia a função de tamanho para todas as linhas. Este capítulo mostrou como reduzir vários grupos de dados usando funções de agregação; e o capítulo anterior Alegações de Inocência era apenas um caso especial no qual a tabela inteira é um grupo.
No próximo capítulo, aprenderemos sobre JOINs, que permitirão trabalhar com múltiplas tabelas.