Lange staarten
Een lange staart verwijst naar een klein aantal waarnemingen die een groot aantal keren voorkomen. Wanneer we deze in een grafiek uitzetten, vormen ze een smalle strook ver rechts van het zwaartepunt, die eruitziet als een staart. Ze wijzen op de aanwezigheid van uitschieters waarvan het ongewone gedrag interessant voor ons kan zijn.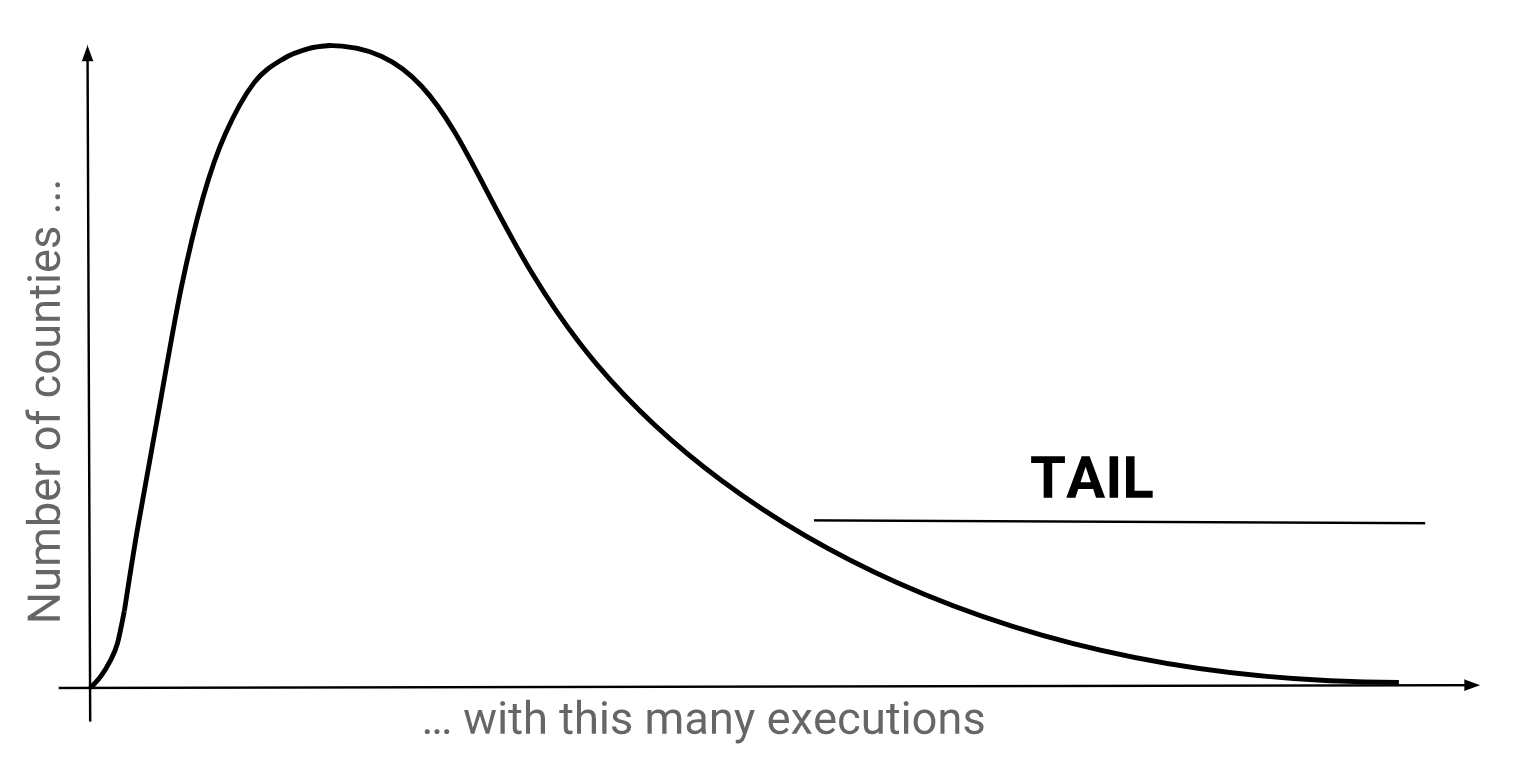 In de context van executies in Texas verwijst de lange staart naar een klein aantal counties waarvan bekend is dat ze een groot aantal executies hebben uitgevoerd.
Laten we voor elke county het percentage van de executies bepalen, zodat we de counties in de staart eruit kunnen pikken.
Zoals steeds duidelijker zal worden, vertelt de vorm van de tabellen ons veel over de bewerkingen die we moeten uitvoeren. (Dit is vergelijkbaar met dimensieanalyse in de natuurkunde.) In dit geval kunnen we vaststellen dat de methoden die we tot nu toe hebben behandeld ontoereikend zijn: het hoofdstuk over Beazley ging over afzonderlijke rijen gegevens, maar het is duidelijk dat we moeten aggregeren om gegevens op countyniveau te krijgen. Het hoofdstuk Beweringen van onschuld leerde ons aggregeren, maar die functies zouden de hele dataset samenvoegen tot één rij, terwijl we eigenlijk één rij per county willen.
Het GROUP BY-blok
Hier komt het GROUP BY-blok om de hoek kijken. Hiermee kunnen we de dataset opsplitsen en binnen elke groep aggregatiefuncties toepassen, wat resulteert in één rij per groep. De meest eenvoudige vorm is GROUP BY <kolom>, <kolom>, ... en het komt na het WHERE-blok.
Als je je Een vreemde query herinnert, zouden er nu alarmbellen moeten afgaan in je hoofd. Hadden we niet net geleerd om geaggregeerde en niet-geaggregeerde kolommen niet te mengen? Het verschil hier is dat groeperingskolommen de enige kolommen zijn die niet geaggregeerd hoeven te worden. Alle rijen in een groep hebben immers dezelfde waarden in die kolommen, dus er is geen onduidelijkheid over de waarde die moet worden teruggegeven.
Je hebt misschien ook ons gebruik van AS opgemerkt. Dit noemen we “aliasing”. In het SELECT-blok geeft <expressie> AS <alias> een alias waarnaar later in de query kan worden verwezen. Dit bespaart ons het herhalen van lange expressies en stelt ons in staat om het doel van de expressie te verduidelijken.
Het HAVING-blok
De volgende oefening laat zien dat het filteren via het WHERE-blok plaatsvindt vóór het groeperen en aggregeren. Dit is terug te zien in de volgorde van de syntaxis, want het WHERE-blok komt altijd vóór het GROUP BY-blok.
Dit is allemaal goed en wel, maar wat als we willen filteren op het resultaat van het groeperen en aggregeren? We kunnen toch niet vooruitspringen in de tijd en daar informatie vandaan halen. Om dit probleem op te lossen, gebruiken we HAVING.
Oefenen
Deze quiz is bedoeld om je begrip op de proef te stellen. Lees de uitleg, ook als je alles goed hebt.
Geneste queries
Nu vraag je je misschien af: zouden we niet klaar zijn als we gewoon zoiets als dit konden uitvoeren?
SELECT
  county,
  PERCENT_COUNT(*)
FROM executions
GROUP BY county
Percentages zijn zo’n veelgebruikte maatstaf—zou zo’n functie niet moeten bestaan? Helaas niet, en misschien met goede reden: zo’n functie zou zowel binnen de groepen moeten aggregeren (om de teller te krijgen) als over de hele dataset (om de noemer te krijgen). Maar een query heeft óf een GROUP BY-blok, óf niet. Wat we dus echt nodig hebben, zijn twee aparte queries: een die aggregeert met een GROUP BY en een andere die aggregeert zonder. Die kunnen we vervolgens combineren met een techniek die “nesten” heet.
Hier is een voorbeeld van hoe nesten werkt. De haakjes zijn belangrijk om de grens aan te geven tussen de binnenste query en de buitenste:
Nogmaals: nesten is hier nodig omdat de computer in de WHERE-voorwaarde, terwijl hij een rij inspecteert om te beslissen of de laatste verklaring de juiste lengte heeft, niet buiten die rij kan kijken om de maximale lengte over de hele dataset te bepalen. We moeten de maximale lengte apart bepalen en die aan de voorwaarde doorgeven. Laten we nu hetzelfde concept toepassen om per county het percentage executies te bepalen.
Ik heb er stilletjes een ORDER BY-blok tussen gestopt. De vorm is ORDER BY <kolom>, <kolom>, ... en je kunt het aanpassen door DESC toe te voegen als je niet de standaard oplopende volgorde wilt.
Harris County
Is het verrassend dat Harris (waar de stad Houston ligt), Dallas, Bexar en Tarrant samen goed zijn voor ongeveer 50% van alle executies in Texas? Misschien wel, vooral als we ervan uitgaan dat executies gelijk over de counties verdeeld zouden moeten zijn. Maar een betere eerste benadering is dat executies verdeeld zijn in verhouding tot de bevolking. De volkstelling van Texas uit 2010 laat zien dat de 4 counties samen 10,0 miljoen inwoners hadden, wat 40,0% is van de bevolking van Texas (25,1 miljoen). Dat maakt de bevinding iets minder verrassend.
Maar als we deze staart verder uitsplitsen, zien we dat Harris County verantwoordelijk is voor het grootste deel van het verschil. De county heeft slechts 16,4% van de bevolking, maar 23,1% van de executies. Dat is bijna 50% meer dan je zou verwachten.
Talloze studies hebben onderzocht waarom Harris County zo productief is geweest, en er zijn verschillende factoren aangedragen:
-
De vervolging is goed georganiseerd en ruim gefinancierd, terwijl de verdediging door de rechtbank wordt betaald en weinig prikkels heeft. (Bron, zie p49)
-
De officier van justitie die er lange tijd zat, was vastberaden en enthousiast over de doodstraf.
-
Rechters in Texas worden gekozen, en de bevolking steunt de doodstraf. (Bron)
-
Het systeem van checks and balances in de rechtspraak van Harris County heeft niet gewerkt. (Bron, zie p929)
Samenvatting
In dit hoofdstuk hebben we geleerd om over groepen te aggregeren en om met nesten de uitvoer van een binnenste query te gebruiken in een buitenste query. Deze technieken hebben het zeer praktische voordeel dat we er percentages mee kunnen berekenen.
MapReduce
Een interessante kanttekening is dat we eigenlijk net hebben geleerd hoe je MapReduce in SQL doet. MapReduce is een bekend programmeerparadigma dat berekeningen opvat als een "map"-stap en een "reduce"-stap. Je kunt hier meer leren over MapReduce.
Het hoofdstuk over Beazley ging helemaal over mappen, omdat het ons liet zien hoe we allerlei bewerkingen op alle rijen kunnen toepassen. SELECT LENGTH(last_statement) FROM executions past bijvoorbeeld de lengtefunctie toe op alle rijen. Dit hoofdstuk liet ons zien hoe we groepen gegevens kunnen reduceren met aggregatiefuncties; en het vorige hoofdstuk, Beweringen van onschuld, was slechts een speciaal geval waarin de hele tabel één groep vormt.
In het volgende hoofdstuk leren we over JOINs, waarmee we met meerdere tabellen kunnen werken.