Intervalos sem Execuções
Este gráfico mostra as execuções ao longo do tempo.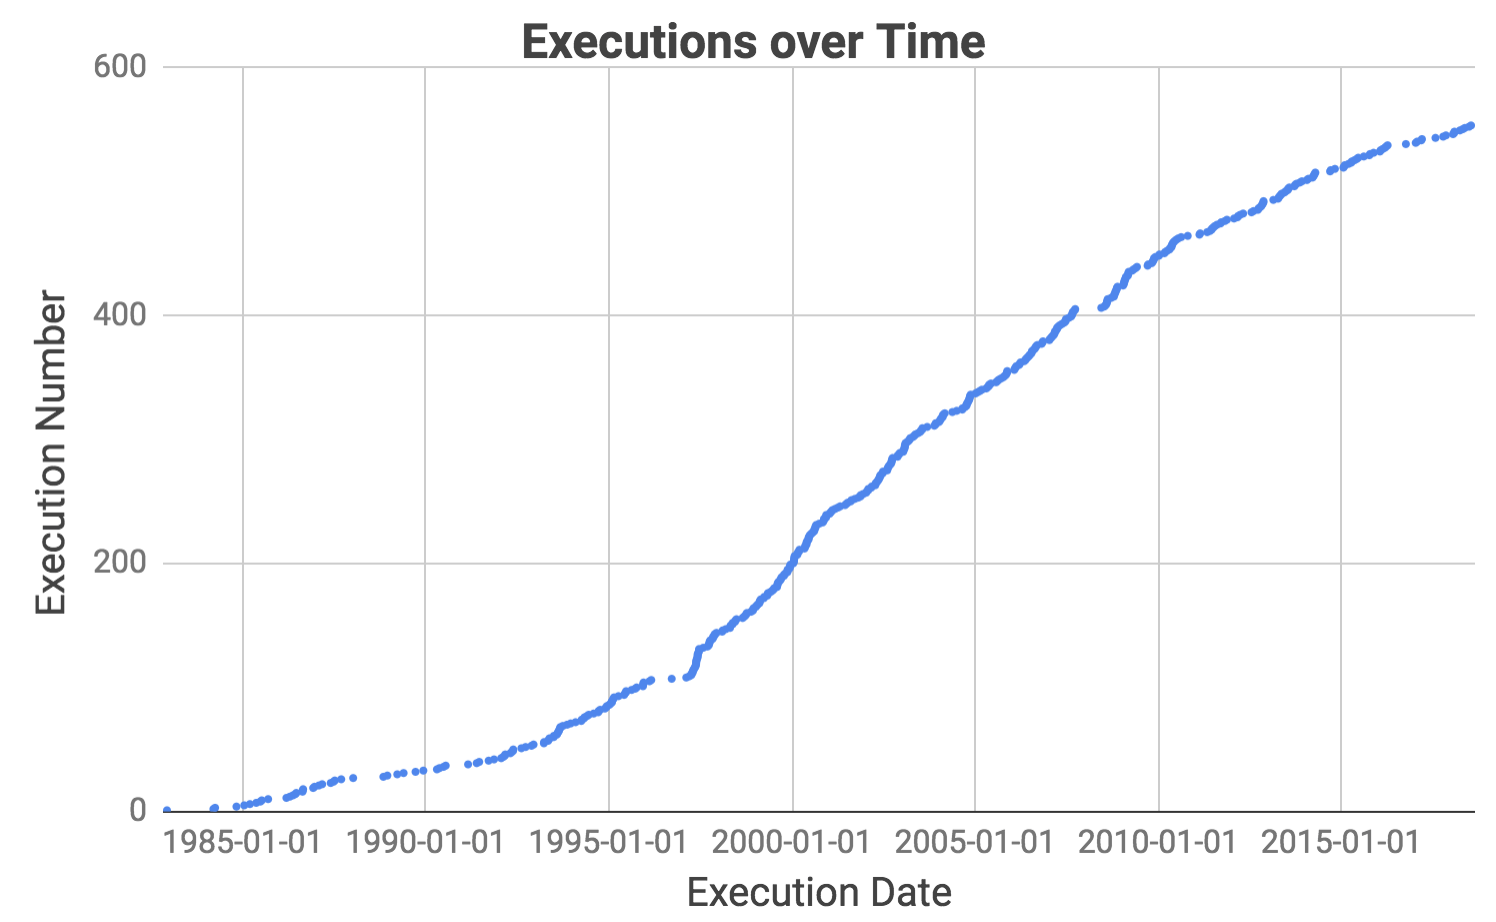 Observe que houve vários períodos prolongados em que nenhuma execução ocorreu. Nosso objetivo é descobrir exatamente quando eles aconteceram e pesquisar suas causas.
Nossa estratégia é colocar a tabela em um estado no qual cada linha também contenha a data da execução anterior. Podemos então encontrar a diferença de tempo entre as duas datas, ordená-las em ordem decrescente e identificar os maiores intervalos sem execuções.
Pensando em JOINs
Nenhuma das técnicas que aprendemos até agora é adequada aqui. Nossa tabela desejada tem o mesmo tamanho da tabela original executions, então podemos descartar as agregações, que produzem uma tabela menor. O capítulo Beazley ensinou apenas operações sobre linhas, o que nos limita a trabalhar com informações já presentes nas linhas. No entanto, a data da execução anterior está fora de uma linha, então precisamos usar JOIN para trazer as informações adicionais.
Vamos supor que as informações adicionais que queremos existam em uma tabela chamada previous, que tenha duas colunas (ex_number, last_ex_date). Poderíamos executar a seguinte consulta para concluir nossa tarefa:
SELECT
  last_ex_date AS start,
  ex_date AS end,
  ex_date - last_ex_date AS day_difference
FROM executions
JOIN previous
  ON executions.ex_number = previous.ex_number
ORDER BY day_difference DESC
LIMIT 10
O bloco JOIN é o foco desta seção. Em vez de vê-lo como uma linha isolada, muitas vezes é útil visualizá-lo assim: 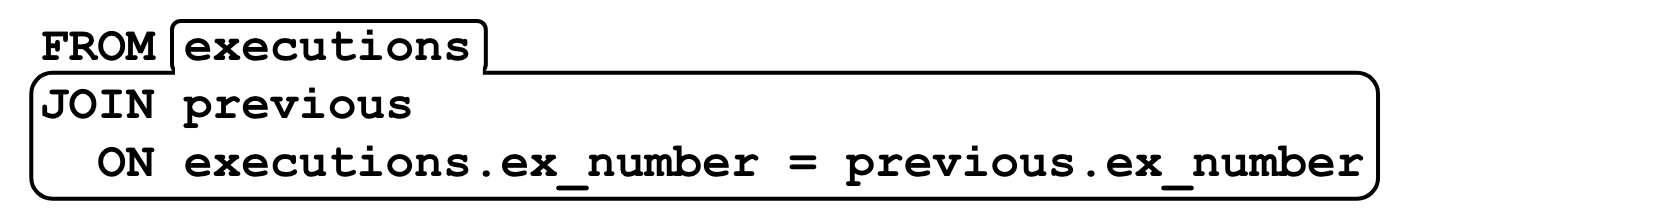 Isso enfatiza como
JOIN cria uma grande tabela combinada que é então passada para o bloco FROM, assim como qualquer outra tabela.
Desambiguando Colunas
A consulta acima também é notável porque a cláusula executions.ex_number = previous.ex_number usa o formato <table>.<column> para especificar colunas. Isso só é necessário aqui porque ambas as tabelas têm uma coluna chamada ex_number.
Tipos de JOINs
O bloco JOIN assume a forma <table1> JOIN <table2> ON <clause>. A cláusula funciona da mesma forma que em WHERE <clause>. Ou seja, é uma expressão que resulta em verdadeiro ou falso e, sempre que uma linha da primeira tabela e outra da segunda se alinham com a cláusula sendo verdadeira, as duas são combinadas:
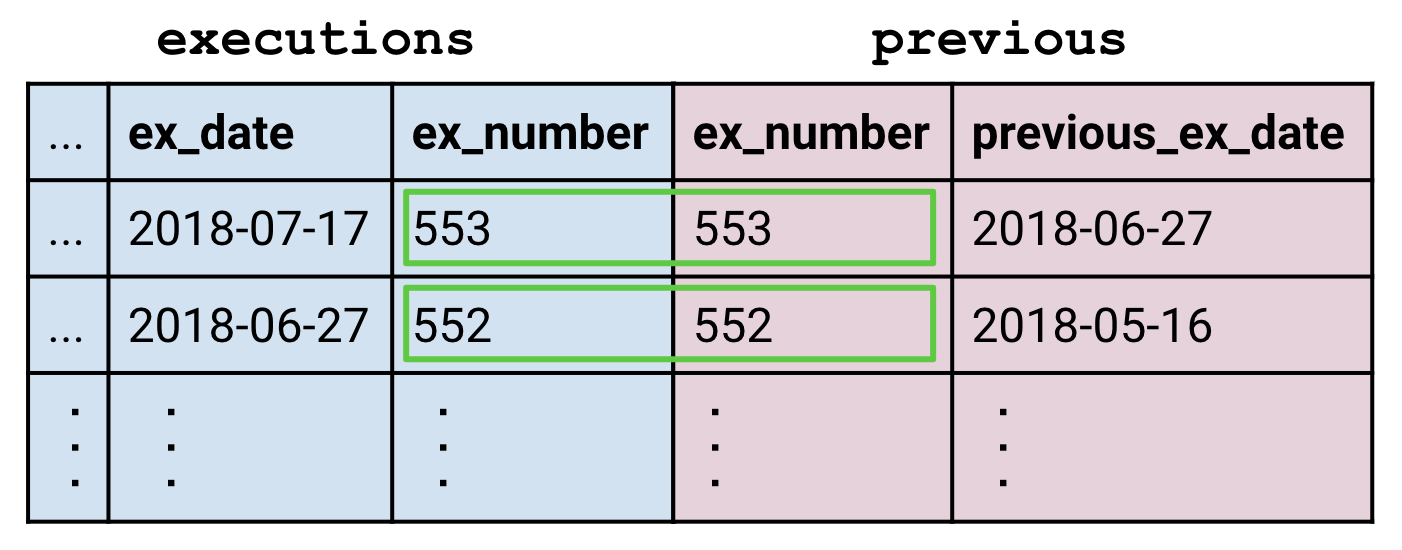
Mas o que acontece com as linhas que não têm correspondências? Nesse caso, a tabela previous não tinha uma linha para a execução de número 1 porque não existem execuções anteriores a ela.
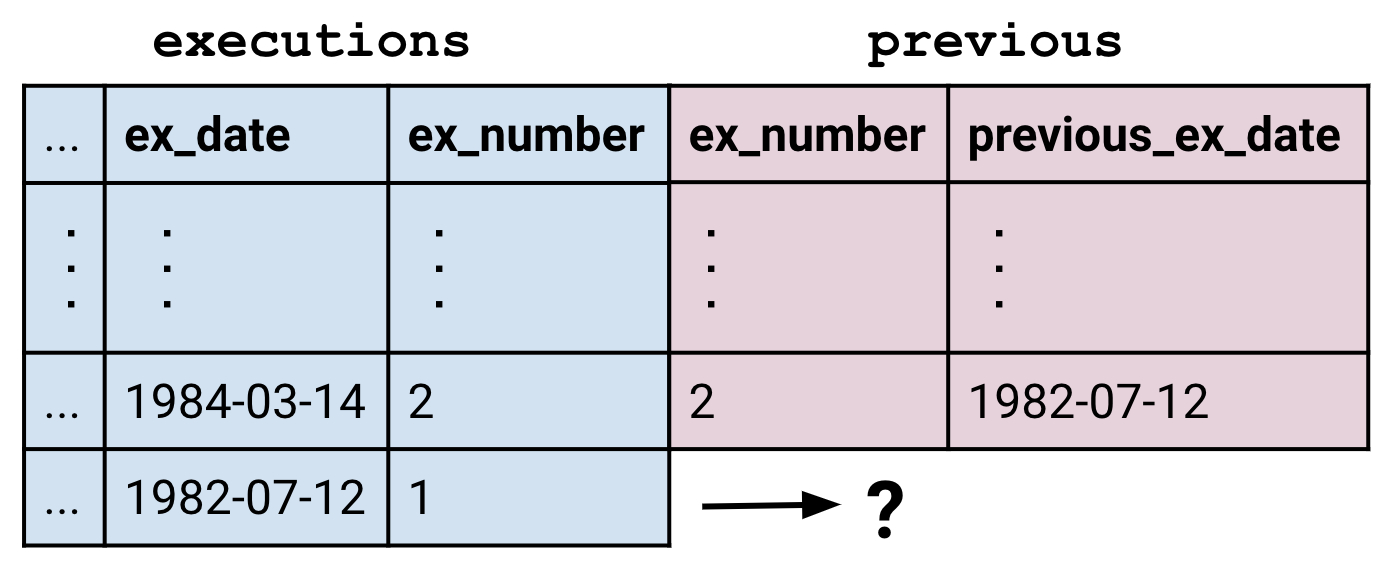
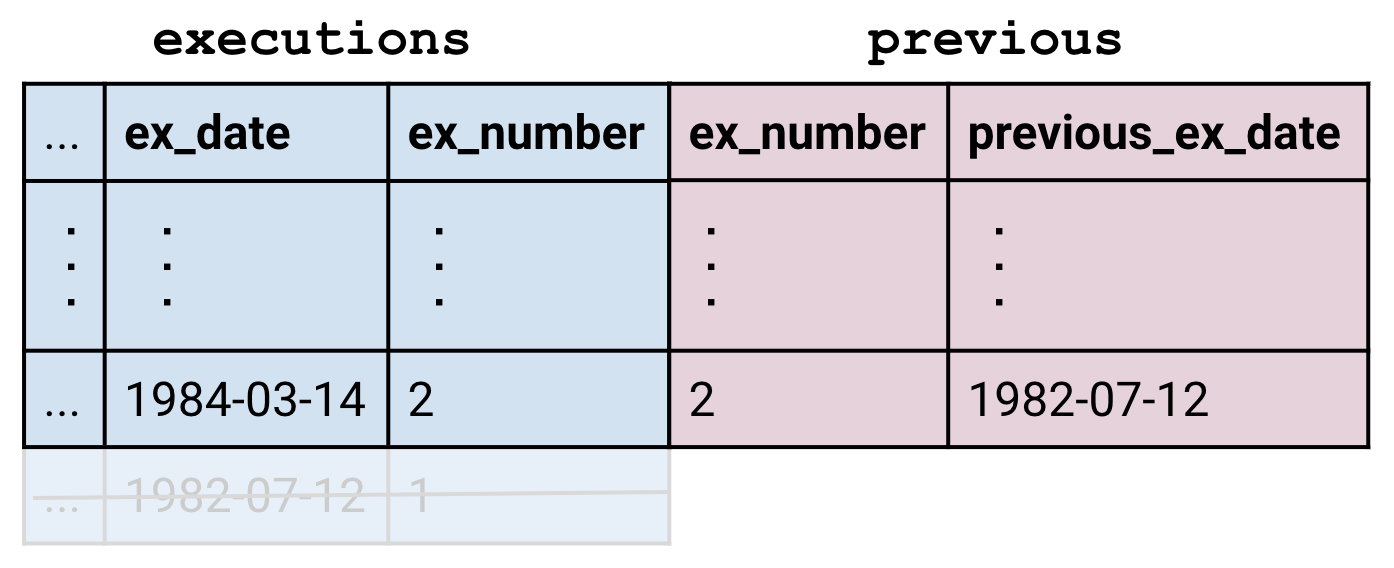
O comando JOIN por padrão realiza o que é chamado de “inner join”, no qual as linhas sem correspondência são descartadas.
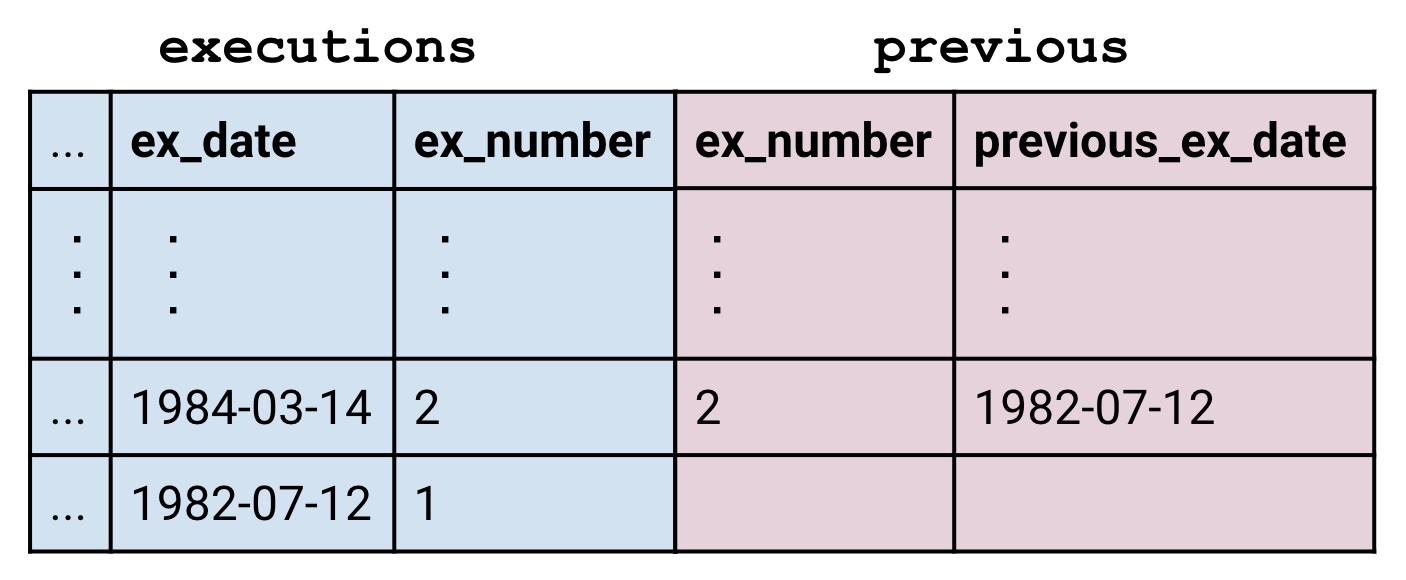
Para preservar todas as linhas da tabela da esquerda, usamos um LEFT JOIN no lugar do JOIN comum. As partes vazias da linha permanecem como estão, o que significa que elas resultam em NULL.
O RIGHT JOIN pode ser usado para preservar linhas sem correspondência na tabela da direita, e o OUTER JOIN pode ser usado para preservar linhas sem correspondência em ambas.
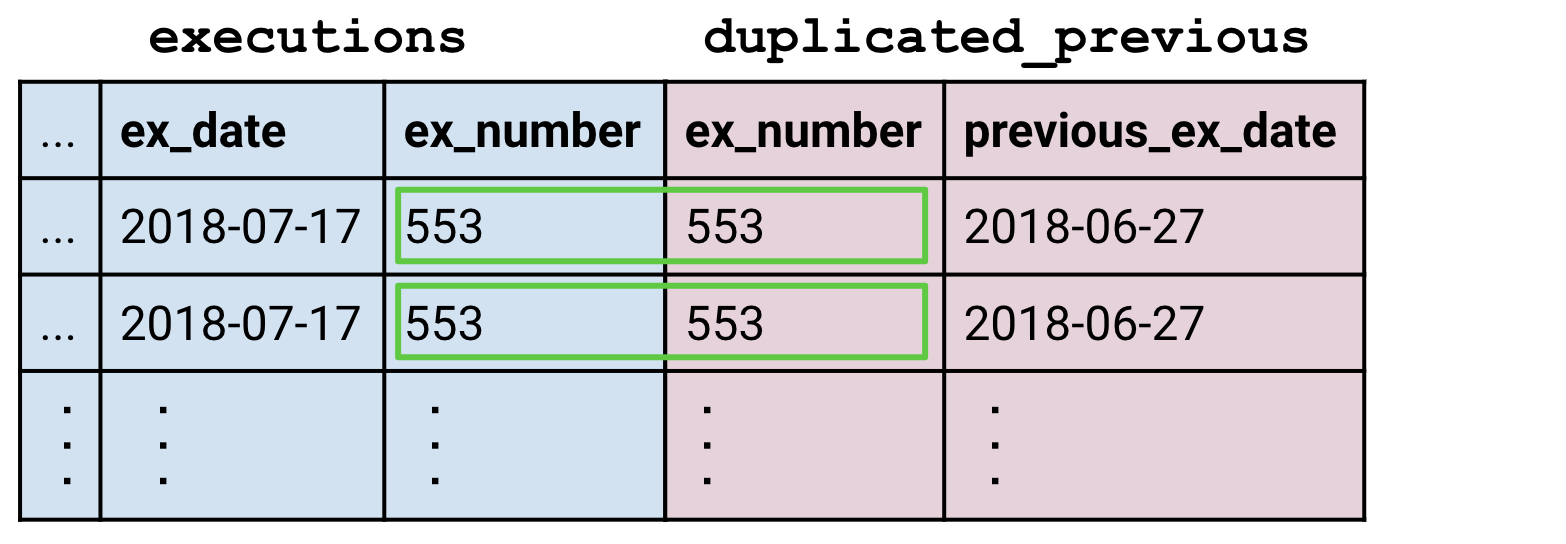
A sutileza final é lidar com múltiplas correspondências. Digamos que temos uma tabela duplicated_previous que contém duas cópias de cada linha da tabela previous. Agora, cada linha de executions corresponde a duas linhas em duplicated_previous.
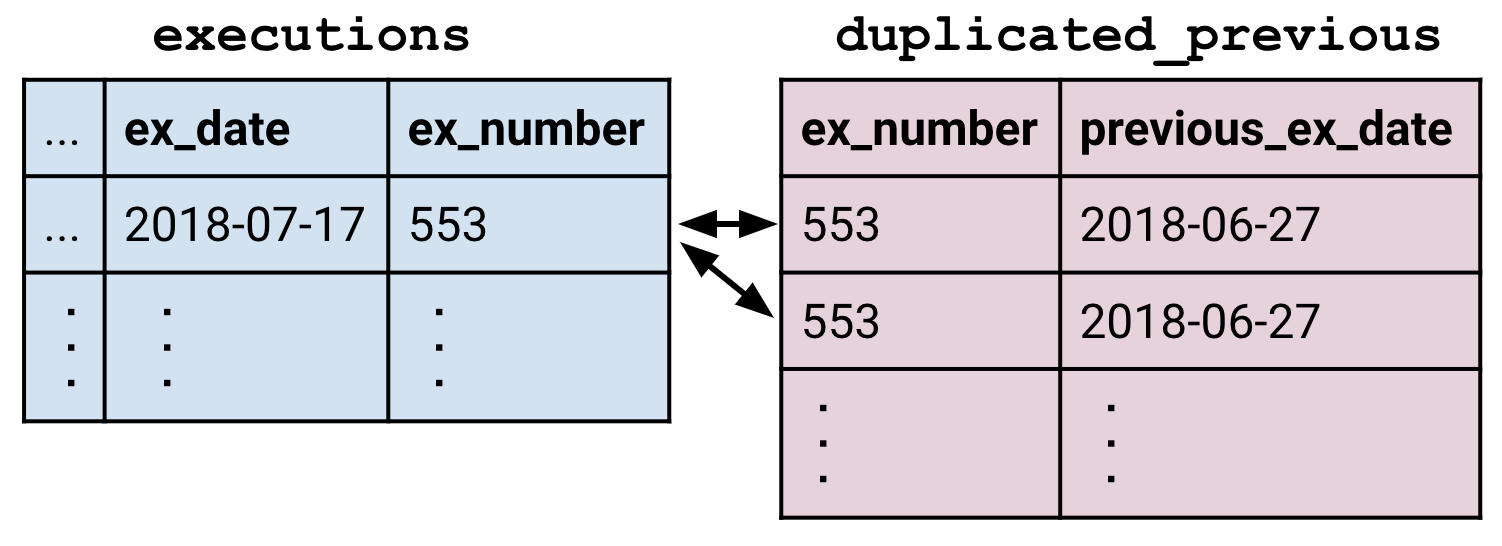
O JOIN cria linhas suficientes de executions para que cada linha correspondente de duplicated_previous tenha sua própria parceira. Dessa forma, JOINs podem criar tabelas maiores do que suas tabelas constituintes.
Datas
Vamos fazer uma pausa nos joins por um momento e olhar para esta linha em nossa consulta modelo:
ex_date - last_ex_date AS day_difference
Fizemos uma grande suposição de que podemos subtrair datas umas das outras. Mas imagine que você é o computador recebendo uma linha como essa. Você retorna o número de dias entre as datas? Por que não horas ou segundos? Para piorar as coisas, o SQLite na verdade não possui tipos de data ou hora (ao contrário da maioria dos outros dialetos SQL), então as colunas ex_date e last_ex_date parecem strings comuns para você. Na prática, estão pedindo que você faça 'hello' - 'world'. Mas o que isso significa?
Felizmente, o SQLite contém várias funções para dizer ao computador: “Ei, essas strings que estou passando para você na verdade contêm datas ou horários. Aja com elas como você agiria com uma data.”
Auto-junções
Com o que aprendemos sobre datas, podemos corrigir nossa consulta modelo:
SELECT
  last_ex_date AS start,
  ex_date AS end,
  JULIANDAY(ex_date) - JULIANDAY(last_ex_date)
    AS day_difference
FROM executions
JOIN previous
  ON executions.ex_number = previous.ex_number
ORDER BY day_difference DESC
LIMIT 5
O próximo passo é criar a tabela previous.
Agora podemos aninhar essa consulta em nossa consulta modelo acima:
previous é derivada de executions, então estamos efetivamente fazendo um JOIN de executions com ela mesma. Isso é chamado de “self join” e é uma técnica poderosa para permitir que as linhas obtenham informações de outras partes da mesma tabela.
Criamos a tabela previous para deixar claro o propósito que ela desempenha. Mas podemos escrever a consulta de forma mais elegante fazendo um JOIN da tabela executions diretamente com ela mesma.
Agora podemos usar as datas precisas dos intervalos sem execuções para pesquisar o que aconteceu durante cada período. Nos anos imediatamente após o fim da proibição da pena capital, houve longos períodos sem execuções devido ao baixo número de sentenças de morte, juntamente com contestações jurídicas à nova decisão. Assim, excluímos os intervalos anteriores a 1993 e nos concentramos em dois grandes intervalos desde então.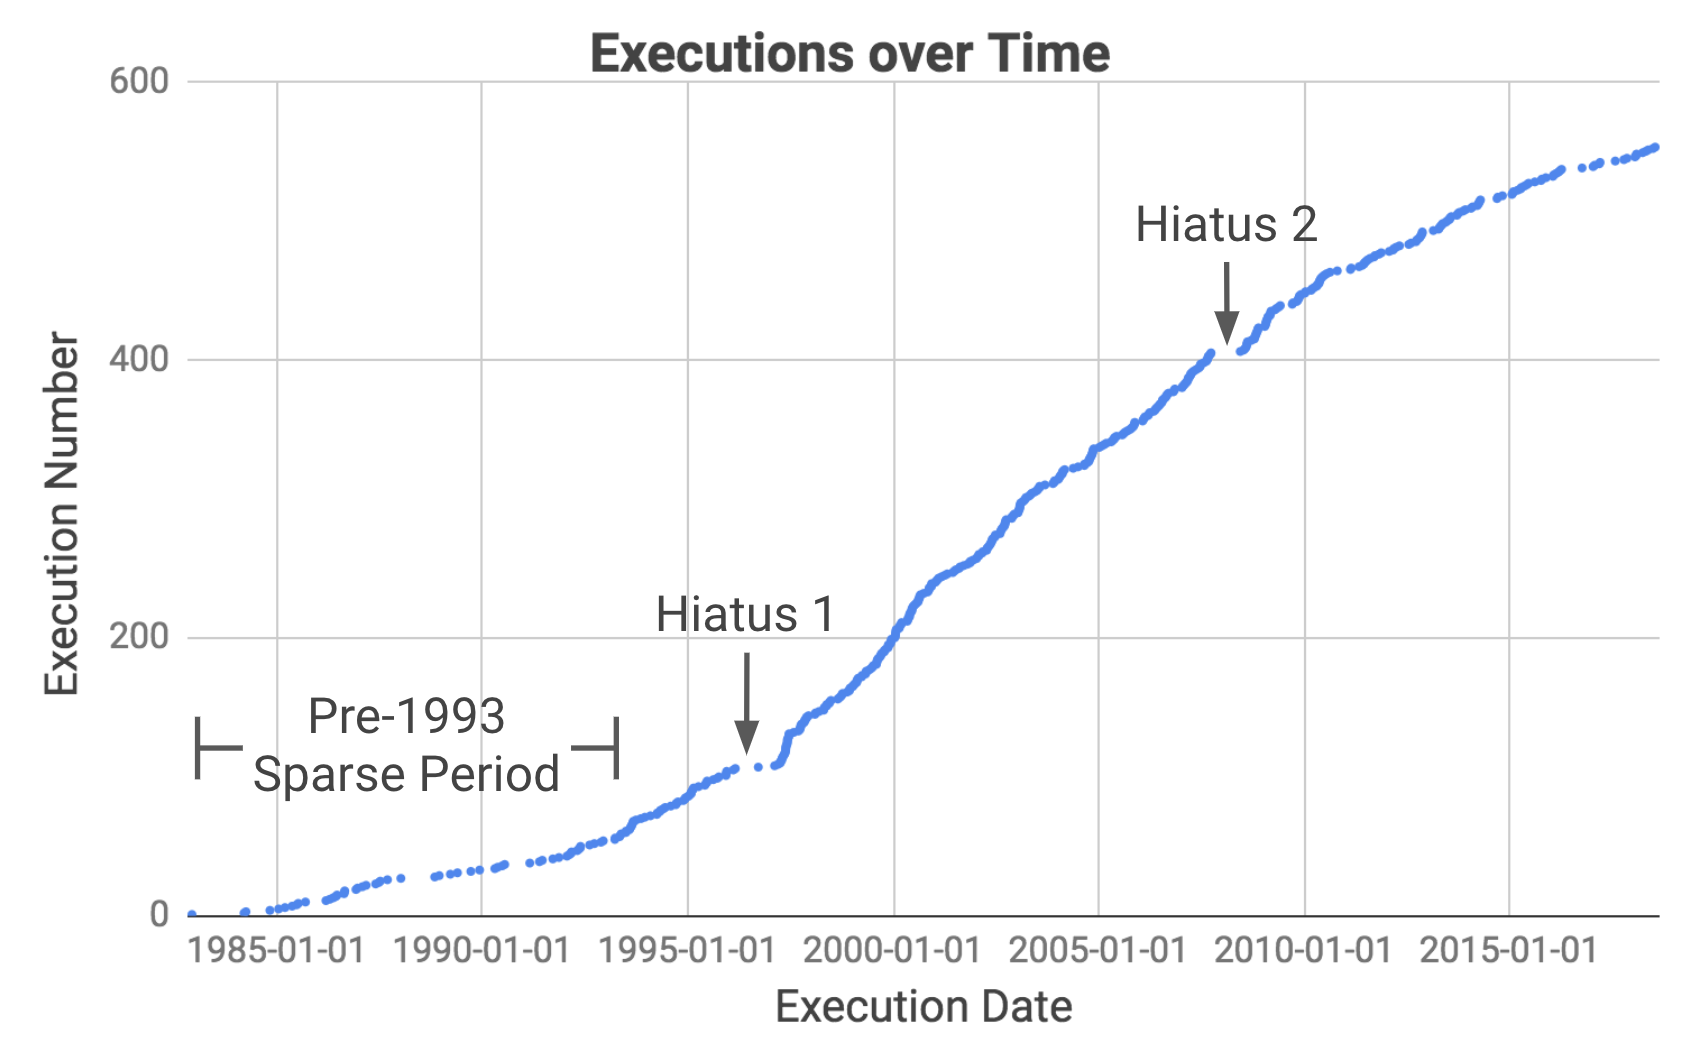
O Intervalo 1 ocorreu devido a contestações jurídicas à Lei Antiterrorismo e de Pena de Morte Efetiva de 1996, criada em resposta aos atentados de 1993 ao World Trade Center e de 1995 em Oklahoma City. A lei limitou o processo de apelação para tornar a pena de morte mais eficaz, especialmente em casos de terrorismo (Fonte).
O Intervalo 2 foi causado por uma suspensão determinada pela Suprema Corte enquanto ela analisava o caso Baze v. Rees, que examinava se a injeção letal viola a Oitava Emenda, que proíbe “punição cruel e incomum”. Isso afetou as execuções em toda a América porque a maioria dos estados usava o mesmo coquetel de medicamentos que Kentucky. A Suprema Corte acabou confirmando a decisão do tribunal de Kentucky, e as execuções no Texas foram retomadas alguns meses depois.
Recapitulação
A ideia central por trás dos JOINs foi criar uma tabela ampliada porque a original não continha as informações de que precisávamos. Esse é um conceito poderoso porque nos liberta das limitações de uma única tabela e nos permite combinar várias tabelas de maneiras potencialmente complexas. Também vimos que, com essa complexidade adicional, manter um controle meticuloso se torna importante. Dar aliases às tabelas, renomear colunas e definir boas cláusulas JOIN ON são técnicas que nos ajudam a manter tudo organizado.